Antigravity CLI で実践する自律実行ループ設計(ループエンジニアリング)
日々の開発・インフラ検証の備忘録として残している個人ノートです。手元環境での動作ログをもとにまとめています。環境差異等もあるため、参考にされる場合はご自身の環境で検証の上ご活用ください。
ループエンジニアリングとは
Google の Addy Osmani 氏は、エッセイ 『Loop Engineering』(2026-06-07) の中で、ループエンジニアリングを 次のように定義しています。
エージェントに指示を与える役割を自分自身から切り離し、代わりにその指示を行うシステムを設計すること
Claude Code の開発を率いるボリス・チェルニー(Boris Cherny)氏も、次のように語っています。
「私はもう、Claude に直接指示を与えていません。Claude に指示を与え、何をすべきかを判断させるループを実行しています。私の仕事は 『ループ(仕組み)』 を書くことです。」 — Boris Cherny (Head of Claude Code, Anthropic)
NOTE
プロンプトエンジニアリングから「ループエンジニアリング」への転換
- 旧来のプロンプトエンジニアリング: 人間が AI と対話しながら 1 問 1 答で手動調整するアプローチ。人間がプロンプトを打ち、出力を目視確認するため、人間の思考速度と確認作業が最大のボトルネックになっていました。
- ループエンジニアリング: AI 自身がツールを実行し、テスト結果から合否を自己判定して自走する**「自動フィードバックの仕組み(自律ループ)」** を設計・構築するアプローチ。人間の役割は「指示係」から「ループの設計者」へとシフトします。
自律ループを支える基本要素
Addy Osmani 氏は自律ループを成立させるための 5つの基本要素(Primitives) と 1つの外部メモリ(Memory) を整理しています。
| 構成要素 | ループ内での役割 | 具体的な実装例 |
|---|---|---|
| 1. Automations(自動化) | 定期実行・タスクの探索とトリガー | 定期監視(/schedule)、ゴール駆動実行(/plan) |
| 2. Worktrees(並行隔離) | エージェント作業の衝突を防ぐ環境分離 | git worktree、独立ブランチでの作業 |
| 3. Skills(スキル) | 特定タスクに必要な手順書・知識のオンデマンド提供 | Agent Skills(SKILL.md / Runbook) |
| 4. Plugins / Connectors | 外部ツールや API との接続 | MCP(GitHub MCP、各種外部ツール連携) |
| 5. Sub-agents(サブエージェント) | 実装担当(Maker)と検査担当(Checker)の分離 | 調査用・レビュー用のサブエージェント分割 |
| + Memory(外部記憶) | セッションを跨いだ知見・進捗の永続化 | Learnings.md や AGENTS.md |
特に重要なのが 「Memory(外部記憶)」 です。
Addy 氏が 「The agent forgets, the repo doesn’t(エージェントは忘れるが、リポジトリは忘れない)」 と述べている通り、 LLM のコンテキストウィンドウの外側(リポジトリ内の Markdown 等)に状態やルールを逃がして引き継ぐことで、初めてセッションが途切れても継続する自律ループが完成します。
5+1 の部品が組み合わさることで生まれる「3 つの核心要件」
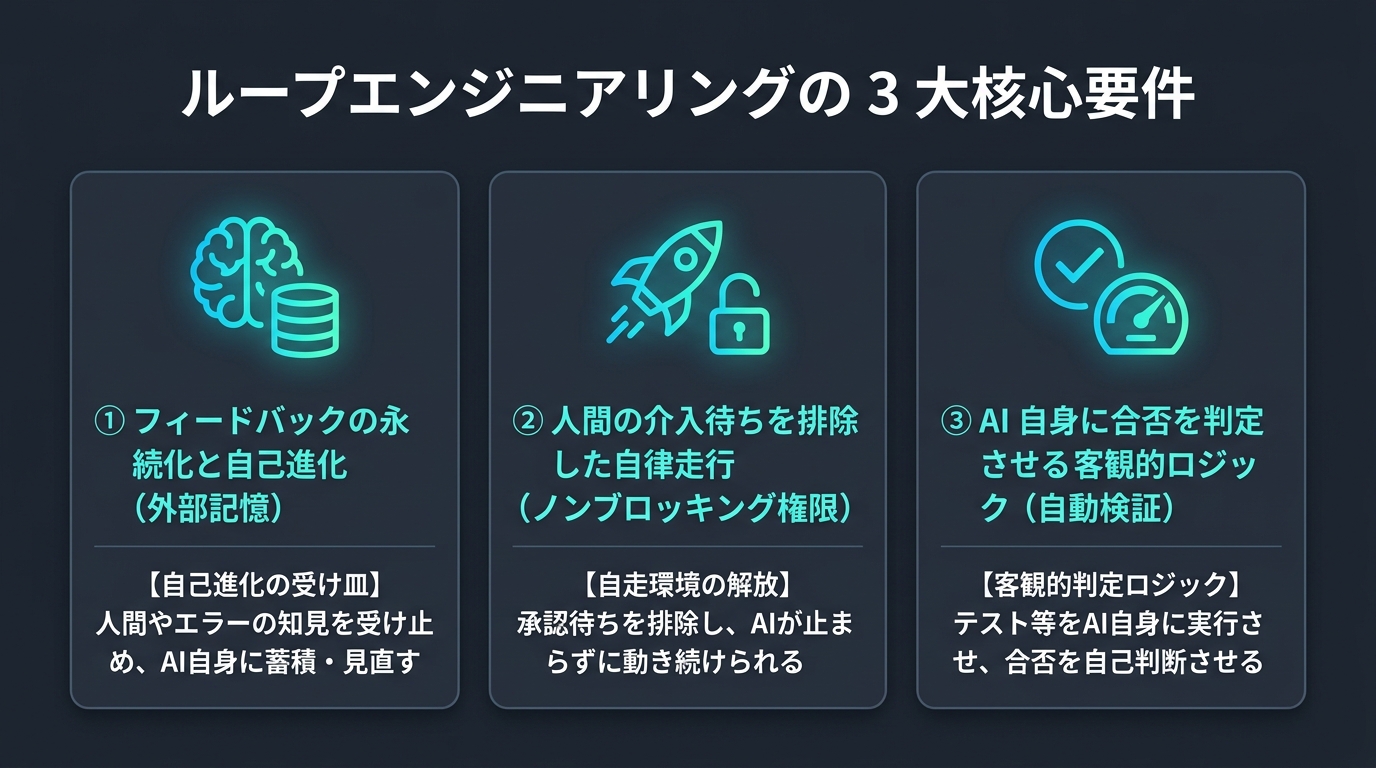
上記の「5+1 の要素」は、ループを組み立てるための 「構成部品(Primitives)」 です。 これらが単体で存在するだけでは自律ループは回らず、適切に組み合わさることで初めて後述する 「3 つの核心要件(メカニズム)」 が満たされます。
- ① フィードバックの永続化と自己進化 ◀
Memory+Skills(知見の蓄積と定型手順のライブラリ化) - ② 人間の介入待ちを排除した自律走行 ◀
Automations+Worktrees(環境隔離というハーネスがあるからこそ安全に自走できる) - ③ AI 自身に合否を判定させる客観的ロジック ◀
Plugins (MCP)+Sub-agents(検証ツールの自動実行とレビュー分掌)
ループエンジニアリングを成立させる 3 つの核心要件
ループエンジニアリングの真髄は、これまで人間が頭を使い、目視で行っていた 「確認・合否判定・やり直し指示(フィードバック)」を、可能な限り AI と判定ロジックの仕組みに委ねること にあります。
ただし、AI に自律的な行動を委ねるには、大前提として 「ハーネス(Harness)」 ── すなわち Docker コンテナや Git ブランチ分離等による 影響の隔離(Sandboxing)と可逆性(Reversibility)を保証する安全な実行環境 ── が整備されている必要があります。このハーネスという土台の上で、以下の 3 つの本質的な足場が不可欠です。
1. フィードバックの永続化と自己進化(外部記憶)
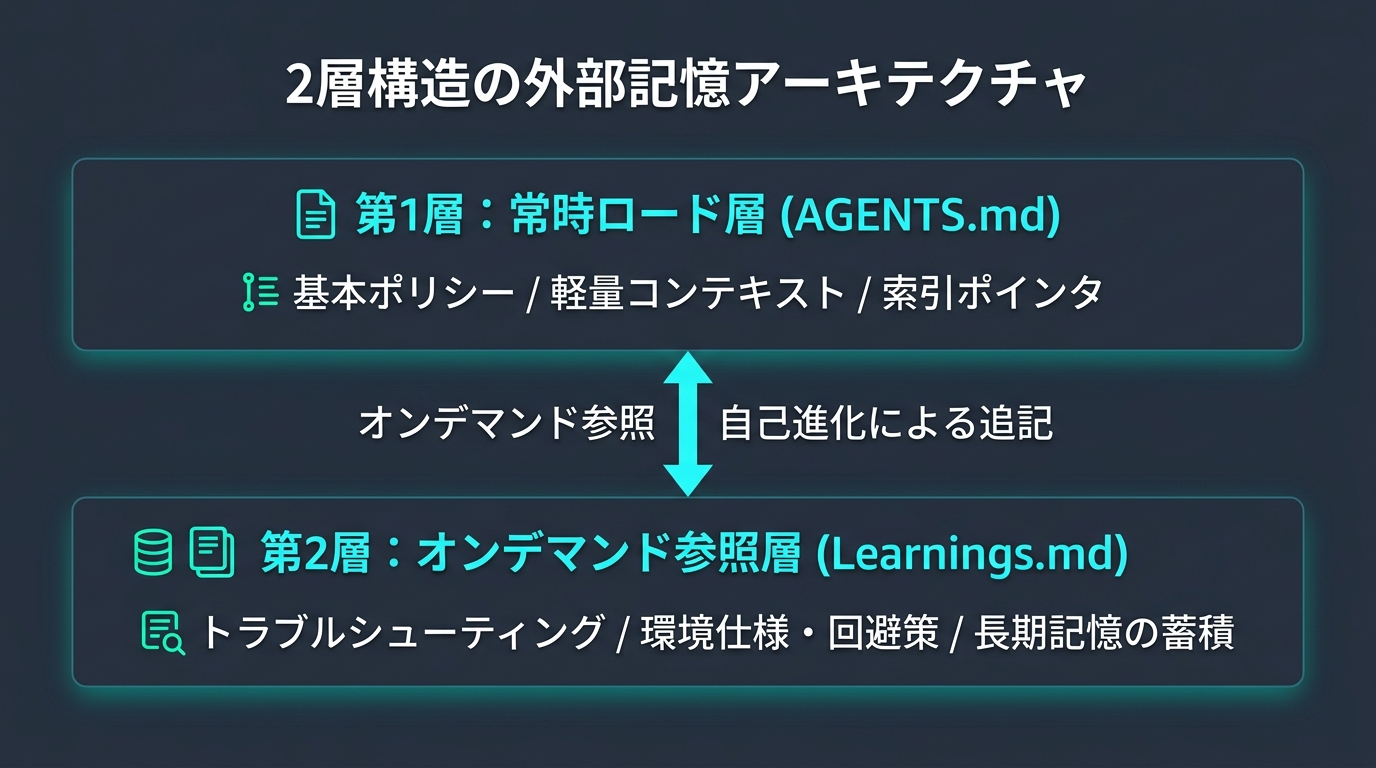
エージェントのコンテキスト肥大化を防ぎつつ、過去の失敗やプロジェクト固有ノウハウを引き継ぐため、外部記憶を 「常時ロード層」 と 「オンデマンド参照・自己進化層」 の 2 つに分離します。
TIP
単一指示ファイルの肥大化が引き起こす 2 つの技術的ボトルネック
AGENTS.md や CLAUDE.md に過去のエラー対策をすべて書き足していくアプローチには、以下の欠陥があります。
- Context Bloat(トークン消費の爆発): 大量の知見が毎ターン送信され、何もしなくても会話開始時点で大量の入力トークンを消費し、レイテンシと API コストが急増します。
- Attention Dilution / “Lost in the Middle” 現象(指示の希釈): スタンフォード大等の研究 『Lost in the Middle』(Liu et al., 2023) の通り、プロンプトが長大化・ノイズ化するほど重要指示に対する注意が希釈され、最重要ルールの遵守率が低下します。
2 層分離設計の動作メカニズム
この課題を解決するのが、AGENTS.md(常時ロード層) と Learnings.md(オンデマンド参照・自己進化層) の 2 層構造です。
TIP
常時ロード層 vs オンデマンド参照層の仕組み
AGENTS.md(常時強制ロード): エージェントツールの基盤仕様として、毎ターンのプロンプトに無条件で自動注入されます。Learnings.md(オンデマンド参照): システムが全行を自動注入することはありません。AGENTS.mdのポインタ指示に従い、エージェントが必要な時だけツール(view_fileやgrep_search)で能動的に検索・読み込みを行う通常ファイルとして扱われます。
「ポインタ(参照)」としての AGENTS.md
単に Learnings.md をリポジトリに置いただけでは、エージェントはそのファイルの存在に気づかない可能性があります。そこで、常時ロードされる AGENTS.md に以下のような ポインタ(索引指示) を 1 行だけ記述します。
| |
これにより、プログラミングにおける「ポインタ・参照渡し」と同じ構造が作られます。
- エージェント起動時:
コンテキストには軽量な
AGENTS.md(数十行)のみが注入され、トークン消費を最小限に抑えます。エージェントは「困ったときはLearnings.mdという外部ナレッジがある」というポインタ情報のみを把握しています。 - タスク実行時(オンデマンド参照):
ビルドエラーや環境固有の仕様に直面した際、エージェントは
AGENTS.mdのポインタ指示に従い、ツール経由でLearnings.mdをピンポイントで検索・読み込みます。 - タスク完了時(自己進化):
新しいバグ修正や仕様の発見があった場合、エージェント自身が
Learnings.mdの末尾に知見を自律的に追記・更新します。
TIP
知見のライブラリ化(Skills への昇格)
Learnings.md に蓄積された断片的な教訓のうち、定型化・複雑化したワークフローは Skills(.agents/skills/*/SKILL.md) へ昇格させます。
スキルは「名前と概要(メタデータ)」のみを軽量保持し、該当タスク実行時のみ全文がオンデマンド注入されるため、トークンを浪費することなく高度な専門手順をライブラリ化できます。
NOTE
外部記憶アーキテクチャの学術的ルーツと実務背景
- Reflexion (Shinn et al., 2023 / NeurIPS 2023): タスク失敗時に自然言語で自己反省(Self-reflection)を行い、言語的メモリ(Verbal Memory)に蓄積して次回試行時に参照させることで、同一エラーの再発を防ぐ手法を実証。
- Voyager (Wang et al., 2023 / スタンフォード大・NVIDIA 等): Minecraft 自律エージェントにおいて、獲得したスキルや手順をディスク上の Skill Library に保存し、必要に応じて動的に検索・再利用する自律学習モデルを確立。
- 実務への定着: 障害対応の事後検証(Post-mortem)から得られる「Key Learnings」文化と、Addy Osmani 氏の「Memory Primitive(The agent forgets, the repo doesn’t)」が接続し、2 層構造が自律ループの基本設計として定着。
2. 人間の介入待ちを排除した自律走行(ノンブロッキング権限)
Automations(ゴール駆動実行や定期監視) によってエージェントを自走させる際、コマンドを実行するたびに対話型の承認プロンプト(Confirmation)を挟むと、自律ループがブロックされて人間が再び作業のボトルネックになります。
たとえば、AI がコードを修正した後に hugo --cleanDestinationDir で検証しようとするたびに「このコマンドを実行してよいですか? [y/N]」と聞かれる状況を想像してみてください。人間が承認ボタンを押すまで AI は完全に停止し、自己修復ループは事実上崩壊します。
日常的に使用するテスト・ビルド・Git コマンドを事前許可(Allowlist 化)し、「人間の確認待ちによるループ停止」を排除 して AI を止まらずに自走させます。
WARNING
「言葉による確認スキップ」と「物理サンドボックス」の決定的な違い
単にプロンプトで「確認してこないで勝手に進めて」と指示したり、全権限を無制限に解放(--dangerously-skip-permissions)するのは、セーフティネットのない危険なノールック運転(YOLO) に過ぎません。
また、「Git があればコードを壊されても戻せる」「テストコマンドだけ許可(Allowlist)すれば安全」という考えにも落とし穴があります。
たとえば npm test や pytest を許可していたとしても、サンドボックスがないホスト環境ではテストプロセス自体がホスト OS の権限で動くため、テストスクリプト内でホスト側の重要ファイルを削除・破壊されるリスク を防げません。
- Git: 「リポジトリ内のコードの可逆性」しか保証しない
- CLI の Allowlist: アプリケーション層の制約に過ぎず、プロセス内部の挙動は防げない
- サンドボックス(Docker / WSL2 等): OS カーネルレベルでホストからプロセスを物理隔離する
だからこそ、自律ループの権限を解放するには、「最悪壊れてもホストに影響せず、即座に捨てて再構築できる物理サンドボックス(ハーネス)」 が絶対の大前提となります。
3. AI 自身に合否を判定させる客観的ロジック(自動検証)
人間が画面に張り付いて良し悪しを目視チェックするのをやめ、Plugins / MCP(ツール実行) を通じて「自動テストやビルドスクリプト」を AI 自身に実行させ、合否を自己判断・自己修復させます。
また、複雑なタスクにおいては Sub-agents(サブエージェント) を活用し、実装担当(Maker)と検査・レビュー担当(Checker)を分掌させることで、人間の代わりに機械的で客観的な二重判定ループを自律的に回すことが可能になります。
TIP
Fast Observability(高速な自動検証)を成立させる 4 要件
- 5 秒以内の高速実行: 検証が遅いと自己修復ループ全体の回転が鈍化します。
- 厳格な終了コード(Exit Code 0/1): 成功/失敗を AI が機械的に判定できるようにします。
- 明瞭な標準エラー出力(stderr): エラー行・スタックトレースから AI が自力で原因特定できるようにします。
- 知見の正確性フィルター: 自動テストをパスして再現性が証明された解決策だけを
Learnings.mdに蓄積します。
Antigravity CLIにおけるループエンジニアリングの実践
これまで解説した 「3 つの核心要件」 を、Antigravity CLI(agy)の各機能(5+1 の構成要素)を使って具体的にどう設定・実装するかを解説します。
3 つの核心要件と Antigravity CLI 機能の実装対応
| 核心要件 | Antigravity CLI での実装要素(5+1) | 具体的なツールと設定ファイル |
|---|---|---|
| 1. フィードバックの永続化と自己進化 | Memory + Skills | AGENTS.md、Learnings.md、.agents/skills/*/SKILL.md |
| 2. 人間の介入待ちを排除した自律走行 | Permissions + Worktrees + Automations | settings.json(権限設定)、Workspace: "branch"、/plan、/schedule |
| 3. AI 自身に合否を判定させる客観的ロジック | Fast Observability + Plugins + Sub-agents | 自動検証コマンド、GitHub MCP、Checker サブエージェント |
具体的な環境設定
当ブログ環境における、3 つの核心要件の具体的なセットアップ手順です。
1. フィードバックの永続化:外部記憶とスキル(Memory + Skills)
- 外部記憶(
AGENTS.md/Learnings.md): プロジェクト直下のAGENTS.mdに、基本方針とLearnings.mdに対する参照・自己進化(追記・週次整理)ルールを記述します。
| |
- スキルのライブラリ化(
.agents/skills/*/SKILL.md): 定型化された複雑なワークフロー(例:記事の新規作成手順、画像生成ルール等)は、ディレクトリごとにSKILL.mdとして切り出し、必要な時だけオンデマンドでエージェントに読み込ませます。
2. 自律走行の解放:権限・環境隔離・自動化(Permissions + Worktrees + Automations)
- ノンブロッキング権限(
settings.json): 日常的に使用する検証コマンドや Git コマンドを~/.gemini/antigravity-cli/settings.jsonのpermissions.allowに登録し、確認プロンプトによるループ停止を排除します。
| |
- 作業環境の隔離(Worktrees /
Workspace: "branch"): サブエージェント呼び出し時にWorkspace: "branch"を指定し、Git のブランチ・作業ツリーを完全に分離。メイン環境を破壊するリスクを排除します。 - 自走トリガー(
/planや/schedule、非対話モード-p): ゴール駆動実行(/plan)や定期監視(/schedule)、CI連携(agy -p)により、人間の手動入力を介さずに自走ループを回します。
3. 客観的判定ロジック:自動検証・ツール・分掌(Fast Observability + Plugins + Sub-agents)
- 高速な自動検証(Fast Observability):
エージェントが自己修復ループを回すための「客観的な合否判定コマンド」を用意します。
当ブログでは、出力先(
public/)の過去キャッシュを完全消去した上で、全ページのメタデータ・Markdown 構文・テンプレート(Sass/i18n)の整合性をゼロから 1 秒台で検証するコマンドを定義しています。1 箇所でも不整合があれば Exit Code 1 と明確なエラー行(stderr)が出力されるため、AI が自力で即座に自己修正できます。
| |
- 外部ツール連携(MCP サーバー / Plugins): GitHub MCP などの MCP サーバー(Model Context Protocol) を連携させ、リモートリポジトリの Issue 取得、PR 作成、ファイル操作をエージェントに直接実行させます。
- レビュー分掌(Sub-agents による Maker / Checker 分離):
コードを実装する「Maker エージェント」と、テスト・レビューを担当する「Checker サブエージェント」を
invoke_subagentで分担させ、客観的な二重判定ループを自律実行させます。
他のエージェントツールへの普遍的応用
本記事で解説した 3 大核心要件(2 層外部記憶・ノンブロッキング自走・客観的自動検証)は、Antigravity CLI に限らず、Claude Code や Cursor などの主要なコーディングエージェント環境にもそのまま応用できる普遍的な設計パターンです。
| 核心要件・設計要素 | Antigravity CLI | Claude Code | Cursor |
|---|---|---|---|
| 常時ロード層 | AGENTS.md | CLAUDE.md | .cursor/rules/*.mdc |
| オンデマンド外部記憶 | Learnings.md | Learnings.md | Learnings.md / Notepads |
| 自走コマンド | /plan, /schedule | claude -p / --dangerously-skip-permissions | Agent Mode(Yolo モード) |
| 高速自動検証 | ターミナルコマンド | ターミナルコマンド | Terminal Tool / Task Runner |
ループエンジニアリングにおける現在の課題
ループエンジニアリングは現在進行形で発展しているアプローチであり、実務で運用する上では以下のような課題や限界も存在します。
1. ハーネス(物理サンドボックス)の必須性と非隔離環境でのトレードオフ
AI は確率的・非決定的に動作するため、プロンプトや CLI ツールの設定(ソフトウェア制御)だけで予期せぬ挙動を 100% 防ぐことは原理的に不可能です。そのため、自律ループの構築には OS カーネルレベルでプロセスを封じ込める 「物理サンドボックス(Docker、WSL2、使い捨て VM 等)」が不可欠な前提 となります。
しかし、実務環境(特にコンテナ導入に制約がある Windows ホスト等)において物理サンドボックスを用意できない場合、「安全性と自律性の厳しいトレードオフ」 に直面します。
- 自律性を追求する場合(サンドボックスが必須): ホスト OS を破壊するリスクを排除するため、最低限の隔離環境(WSL2 や Windows Sandbox、独立 VM)を用意してその中でエージェントを動かす必要があります。
- 物理隔離がない場合(安全のために自律性を制限): Allowlist による自動実行はホスト破壊のリスクを伴うため、コマンド実行のたびに人間が目視確認する 「Human in the loop の多発(自律性の犠牲)」を受け入れるのがセキュリティ上極めて正当な判断 となります。
また、Docker 等でサンドボックスを構築した場合でも、ホストマウントされたファイルの誤削除、API トークンの漏洩、リモート Git の誤プッシュなど「絶対的な安全」の保証は困難です。安全性を過信せず、破壊的変更への人間確認を残すなどの多重防御(Defense in Depth)が求められます。
2. 良質な自動検証(テスト)の整備・保守コスト
AI が自力で合否を判定するためには、「5 秒以内で Exit Code 0/1 を厳格に返す自動テストやビルドスクリプト」が必要です。このテスト環境自体の作成やメンテナンスに人間の工数がかかり、テストが甘いとバグの見逃し(偽陽性)が発生します。
3. トークン消費と API コストの増大
AI が自律ループの中で試行錯誤(エラー検知 ⇄ コード修正 ⇄ 再検証)を何度も繰り返すと、1 つのタスクで数十万トークンを短時間で消費し、API コストやレート制限(Quota)を圧迫するリスクがあります。
4. 誤学習・間違った知見の固定化(Toxic Learning)
たまたま動いただけの一時的な回避策や誤った解釈を Learnings.md に蓄積してしまうと、次回以降の全セッションで AI がその誤ったノウハウに縛られ続ける危険性があります。
5. テストハック(局所最適化)のリスク
AI が「目の前のテストを通すこと」だけに集中するあまり、全体の可読性やアーキテクチャ設計を犠牲にしたトリッキーなコード(テストハック)を書いてしまう場合があります。
それでもループエンジニアリングに進まざるを得ない理由
これほど多くの課題や初期投資(ハーネス・テストの整備)が必要であるにもかかわらず、なぜ開発の最前線がループエンジニアリングへと向かっているのでしょうか?
その理由は、「人間が間に入ってプロンプトを入力し、目視確認する 1 問 1 答の運用では、スループットに構造的な限界があるため」 です。
- 人間のタイピングと目視速度が「開発速度のボトルネック」になる: AI のモデル知能が向上しても、人間が指示を入力し、出力を確認して修正を指示している限り、全体の生産性は「人間の手動介入速度」で頭打ちになります。
- 手動確認による認知負荷の蓄積: AI の出力コードを人間が毎回目で追い、不備を見つけてプロンプトで修正させる作業は認知負荷が高く、スケールしません。
- 初期投資の先にあるスループットの向上: ハーネスやテストの整備にはコストがかかりますが、一度「自律ループ」を構築すれば、人間が他の作業を進めている間に AI が自走してタスクを完走する高いスループットが得られます。
これは、かつて CI/CD(継続的インテグレーション・自動テスト) が登場した際、「テストを書くのが面倒」「CI の構築コストがかかる」と言われながらも、手動ビルドの時代には二度と戻れなくなった歴史の必然と同じ構造です。
まとめ:安全なハーネスの上で自律ループを回す設計
ループエンジニアリングは、人間が手作業で行っていた「確認・合否判定・やり直し指示」を、AI と自動検証の仕組みに委ねるアプローチです。
安全なハーネス(隔離と可逆性の保証)を大前提として、外部記憶・自走権限・客観的判定ロジック という 3 つの足場を整え、AI 自身に検証と自己進化のサイクルを実行させます。 課題や運用コストも伴うアプローチですが、人間による手動介入のボトルネックを解消し、プロンプトの工夫から「自走する仕組みの設計」へと移行するための実践的なアプローチとして紹介しました。
※ 本記事の構成検討・技術仕様の検証・Hugo による静的ビルド検証・推敲は、AI コーディングエージェントとの自律協働ループによって執筆・検証されています。
参考リンク・情報ソース
ループ工学・エージェント設計
- Addy Osmani: Loop Engineering (2026-06-07)
- WorkOS (Acquired Unplugged): Boris Cherny on Claude Code and Agent Loops (2026-06-02)